手書き数字認識ツールの使い方と学習内容
このツールについて
これまでのページ(勾配降下法・回帰直線・パーセプトロン各種)は,あらかじめ用意された少数のデータを学習するものでした. このツールでは,自分の手でキャンバスに書いた数字そのものを訓練データとして使い,784個の入力(28×28ピクセル)を持つニューラルネットワークに0〜9の数字を分類させる. 「本物の画像データを,実際に自分で作って学習させる」という,これまでより一歩実践に近い体験ができる.
使い方
ツール内の①〜④の番号に対応して説明する.
① 手書きで訓練データを作る
キャンバスに0〜9の数字を1つ書き,下の数字ボタンでラベルを選んで「この数字を訓練データに追加」を押す.これを0〜9のすべての数字について少なくとも1回行うと,学習ボタンが有効になる.「訓練データを保存(タグ付き)」で,作ったデータをファイルとして保存できる.
② 学習の設定
隠れ層のユニット数と学習率 η を指定し,「1ステップ実行」「5ステップ実行」「自動実行」でネットワークを学習させる.学習を始めると,「訓練データ一覧」の各サムネイルの下に判定結果を示す印が表示される(赤い○=正解/黒い×=不正解).学習が進むにつれて×が○に変わっていく様子や,「正答率の推移」グラフが確認できる.なお,学習を1回以上実行するまでは判定結果(○×)は表示されない.訓練データを追加しただけの未学習の状態では,ネットワークがまだランダムな初期値のままで,判定に意味がないためである.
③ 学習したモデルで判定してみる
判定用のキャンバスに新しく数字を書き,「使用するモデル」で試したいモデルを選んで「判定する」を押すと,予測結果と数値0から9の10クラス分の確率が棒グラフで表示される.最大確率のものが予測結果になる.
④ 保存したデータで判定する
①で保存した(または他のセッションで保存した)タグ付きデータファイルを最大5個まで読み込み,好きなモデルで一括判定できる.「アップロードした全ファイルを一括判定する」を使うと,複数ファイルの結果をまとめて確認できる.
モデルの保存・管理
| 現在のモデルを保存 | 名前を付けて,今の重みをブラウザ内に保存する(最大5個).学習の異なる段階のモデルを比較するのに使える. |
|---|---|
| ↓(ダウンロード) | 保存したモデルをJSONファイルとしてパソコンに保存し,後で読み込んだり他のセッションで使ったりできる. |
| ファイルからモデルを読み込む | ダウンロードしておいたモデルファイルを読み込み,保存済みモデルの一覧に追加する. |
| 使用するモデル(③④共通) | 「現在の学習中モデル」か,保存済みモデルのどれかを選んで判定に使える. |
学習できる内容
① 画像をニューラルネットワークで扱う方法
28×28ピクセルの画像は,各ピクセルの明るさを並べれば784個の数値からなる1本のベクトルとして表現できる.これをそのままネットワークの入力として使うのが,画像認識の最も基本的な考え方である.
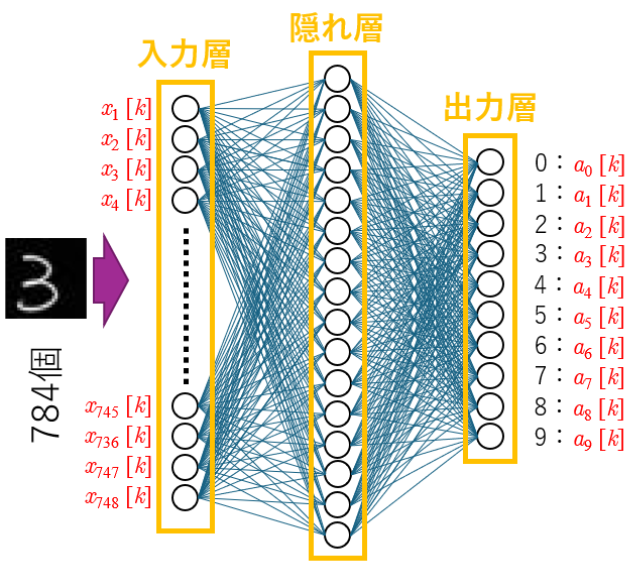
仕組み自体は,これまでのページで扱ってきた「重み付き和+シグモイド関数+誤差逆伝播法」とまったく同じである.入力の数が2個や3個から784個に増えただけで,ネットワークが学習するアルゴリズムは変わらない.
ニューラルネットワークの技術的な内容についてはこのページを見てみよう.
② 前処理(正規化)がなぜ必要か
キャンバスに書いた数字は,書くたびに位置や大きさがバラバラである.もし何も手を加えずにそのまま784次元のベクトルにすると,同じ「3」という数字でも,書く場所が少し違うだけでまったく違うデータとして扱われてしまい,うまく学習できない.
このツールでは,書いたインク部分の外接矩形(ちょうど収まる四角形)を検出し,縦横比を保ったまま正方形に切り出して中央に配置してから28×28にリサイズしている.これにより,同じ数字を少し違う位置・大きさで書いても,ほぼ同じベクトルデータになるようにしている.
③ ハイパーパラメータの役割
「隠れ層ユニット数」と「学習率 η」は,学習そのものが自動で決めるパラメータ(重み・バイアス)とは違い,人間があらかじめ設定する値(ハイパーパラメータ)である.
- 隠れ層ユニット数を増やすと,より複雑な形を表現できるが,訓練データが少ないと逆に学習が不安定になることがある.
- 学習率が高すぎると誤差が振動して収束しにくくなり,低すぎると学習に時間がかかる.
隠れ層ユニット数や学習率を変えて「リセット」→「自動実行」を繰り返し,正答率の上がり方がどう変わるかを比較してみよう.
④ 訓練データと「未知のデータ」への対応(汎化)
「訓練データ一覧」で全部に○が付いても,それはそのデータを覚えたことを意味するだけで,まったく新しく書いた数字を正しく認識できるとは限らない. ③の判定用キャンバスに,訓練データとは違う筆致・大きさで数字を書いて試すことで,モデルが「見たことのある形を暗記しただけ」なのか,「数字そのものの特徴を学べている」のかを確かめることができる.
④の「保存したタグ付きデータをアップロードして判定する」機能を使うと,学習に使っていないテスト用のデータで正答率を測ることができる.一般に,訓練データでの正答率だけが高く,新しいデータでの正答率が低い状態を過学習(オーバーフィッティング)と呼ぶ.訓練データを増やしたり,隠れ層ユニット数を調整したりすることで,この差を縮められるかどうか試してみてみよう.
⑤ モデルを保存して比較する意味
学習の初期・中盤・収束後など,異なるタイミングでモデルを名前を付けて保存し,③の判定パネルで切り替えながら同じ手書き数字を判定してみると,学習が進むにつれて予測の確信度(確率の高さ)が変化していく様子を直接比較できる.これは,実際の機械学習プロジェクトで「どのタイミングのモデルを採用するか」を検討する作業に近い体験である.
ホーム>>カテゴリー別分類>>データ分析>>手書き数字認識ツールの使い方と学習内容
最終更新日:2026年9月29日